我最近拿一段很普通的素材,试了一次 AI 自动剪短视频。
素材不复杂:两个人坐在镜头前,聊一批冲浪相关的好物。没有剧情,没有多机位,也没有什么复杂运镜,主要就是口播、产品卡片和字幕。按直觉,这应该是自动剪辑最容易处理的一类视频。
结果连续迭代了几版,还是没到发布标准。最后真正发出去的版本,主片还是手剪的,只把 AI 留给了字幕。
这次失败有意思的地方,并不在于证明"AI 剪辑不行"。它让我看见了一个更具体的问题:现在很多自动剪辑工具,主要还在优化 transcript,对一条视频怎么成立这件事,理解得很浅。
这个自动剪辑方案到底在做什么
这次用的是 browser-use 开源的 video-use 项目。它的定位很明确:用 coding agent 剪视频。把项目装到 Claude Code、Codex 这类有 shell 权限的 agent 环境里,丢一组素材进去,通过对话生成 final.mp4。
它没有把整条视频扔给一个"视频理解大模型"去看。它先把视频拆成两层材料,再交给 LLM 处理。
第一层是词级 transcript。每个词都有时间戳、说话人信息和停顿信息。也就是说,LLM 主要是在读视频。
第二层是按需生成的 timeline_view。只有在需要判断某个 cut 点、某段反应、某个画面状态时,它才生成局部画面条、波形和词标签。视觉只在关键处出现,像临时调出来的一盏小灯。
然后 LLM 根据 transcript 生成 EDL,也就是剪辑决策表:保留哪一段,从几秒到几秒,属于哪个 beat,为什么保留。最后由 ffmpeg 执行切段、拼接、叠字幕、加卡片、标准化音量。
这套架构很实用。成本低,可控,可复现,也适合程序化执行。它能处理很多专业剪辑里很烦但很机械的事,比如按词边界切、避免切进单词、给 cut 点加 30ms fade、把字幕映射到输出时间线、确保字幕最后叠加。
但它也有一个前提:视频可以先被 transcript 表示。
对于教程、产品 demo、访谈摘录、会议精剪,这个前提通常没问题。因为这些内容的结构基本写在话里。
好物分享口播不太一样。它的结构经常藏在语气、关系、玩笑、铺垫、回调和类目切换里。真正重要的东西,未必长得像"信息"。
我一开始以为问题是颗粒度
第一版失败后,我的判断是:剪辑颗粒度太粗。
当时做的是句级剪辑。LLM 从 transcript 里挑选看起来有信息量的句子,每个 cut 都是一段连续时间区间。问题很快就出来了:段落边界可能干净了,但段落内部的"就是、然后、嗯、啊"、重复表达和松散语流还全都在。
所以我当时以为,不能只选句子,要进到字级或词级。
第二轮开始做字级重剪:识别 filler word,生成删词清单,把明显重复、无意义承接、密集出现的"就是/然后/这个/那个"剪掉。技术上确实进了一步,成片也更短、更紧。
但还是不好看。
这就说明,问题比"句级还是字级"麻烦。字级只是刀更锋利。如果不知道什么该切、什么该留,刀越锋利,破坏力越大。
真正的问题是目标函数错了
video-use 的默认工作方式,很容易把剪辑理解成一件事:
从 transcript 中找出最有信息量的部分,删除低信息密度内容,生成更紧凑的视频。
很多场景里,这个目标是对的。产品发布口播,观众想快速听到观点;教程视频,观众想少听废话、多看步骤。
把"信息密度最大化"套到好物分享视频上,目标就偏了。
这类视频靠另一套结构撑起来:
- 先用一个轻的 hook 让观众进来
- 告诉观众这期为什么值得看
- 按类目组织产品,避免机械罗列
- 每个产品有一个小弧线:为什么需要、推荐哪个、怎么用、适合谁
- 中间保留人物关系和反应,让视频不像说明书
- 最后把推荐强度推到一个高点,再自然收尾
在这套结构里,很多"非信息"片段很重要。
开场广告费玩笑本身没有产品信息,却能把人带进来。 "OK 下一趴"算不上干货,但它像一个小路牌,把观众从一个模块带到下一个模块。 中间再次提到广告费,是 callback,前面埋过,后面才接得上。 两个人的笑和反应,也不该被当成噪音,那里面有人物关系。 "我之前被救护车拉走了就低钾"看似只是经历,后面的电解质推荐却靠它站住了。 "最推荐的是理肤泉 B5"也超出了品牌名本身,它在那条片子里承担了推荐峰值。
自动剪辑容易把这些东西看成"可删",因为它们不符合 transcript 层面的信息密度标准。可成片需要的恰恰是这些骨架。
所以这次失败的根因在这里:AI 把视频当成了一篇需要压缩的文字稿。
为什么 reference 一看就更顺
人工剪辑版做的事,比压短原素材多得多。它在重建结构。
它的顶层是节目骨架:开场、主题、几个类目、收尾。 中层是类目组织:运动前、运动中/后、恢复、头发、皮肤修复。 底层才是单个产品:痛点、品牌、用法、推荐力度。
这也是为什么人工版虽然更长,却不显得拖。它有路。
自动版的问题是:产品基本都出现了,废话也删了一部分,但观众不知道自己走到哪里了。它像把一篇文章的句子压缩过,却顺手删掉了小标题、转场句和段落逻辑。
短视频首先是一条观看路线。把它剪成 transcript 的压缩包,味道就变了。
工具之外的问题
我又看了一轮当前主流工具公开展示的能力。大多数工具解决的,还是"剪辑执行层"的问题。
Descript 的 filler word 功能可以逐个预览并选择删除方式,还提供避免生硬 cut 的音频分析。它关心的是:删掉这个词之后,声音会不会难听。至于这个词所在的段落是不是结构件,它并不替你判断。而且它目前主要适用于英文 transcript;中文里的"就是/然后/这个"这类口头禅,仍然需要其他工具或自定义规则。 Adobe Premiere Pro 的 text-based editing 可以通过编辑 transcript 改变视频时间线,实际提高的是人工剪辑效率,结构判断仍然在剪辑师身上。 Gling、CapCut、OpusClip 这类工具可以自动删停顿、删 filler、找短视频高光、加字幕、生成 B-roll 或做 reframing。它们默认更偏向"提效"和"包装"。一条具体口播内容的节目结构,仍然要有人来判断。 DaVinci Resolve 20 的 AI IntelliScript、Multicam SmartSwitch 更进一步,开始处理脚本匹配、多 take 组装、说话人切换,但它们也主要是在已有脚本、已有机位和明确制作流程里做 first pass。
边界其实挺清楚:AI 已经能很好地帮你做粗剪、删词、字幕、包装、重构时间线。可如果视频没有事先写好的脚本,内容价值又依赖自然对话里的结构、关系和语气,它还需要一个"结构标注层"。
没有这一层,自动化越强,越容易把视频剪成一串"信息点"。
当前方案能补什么,补不了什么
拆得细一点,现有方案大概分成四类。
第一类是 transcript editor。代表是 Descript、Premiere Pro 的 text-based editing、Gling、CapCut。它们把"剪时间线"变成"改文字",能大幅降低删停顿、删口误、删 filler 的成本。Descript 甚至会判断某个 filler 删掉后是否会造成难听的切口,不过这项能力目前主要面向英文 transcript;CapCut 也强调预览和保持自然语气。这类工具适合做第一遍清理,但它们不替你决定节目结构。
第二类是 clipping / repurposing 工具。代表是 OpusClip。它更擅长从长视频里找适合短视频传播的片段,再自动加字幕、改版式、补 B-roll、做平台适配。它能帮你从长内容里找高光,也能把片段包装成 shorts;要把一条自然口播重新剪成完整、顺畅、有结构的正片,还是另一回事。
第三类是专业 NLE 的 AI first pass。比如 DaVinci Resolve 20 的 IntelliScript 可以根据原始脚本组织多 take,Multicam SmartSwitch 可以根据说话人、唇动、广角/近景等信息做多机位切换。这类能力更接近专业流程,但前提也更明确:有脚本、有多 take、有多机位,或者至少有清晰的后期意图。我们这次卡住的地方不在切得快不快,而在素材没有预先脚本化,结构得从自然对话里捞出来。
第四类是生成式 reauthoring。研究上已经有系统在尝试对 talking-head 视频做"像改文字一样改视频":增加、删除、重定时口播内容,再用生成模型补口型、动作和画面连续性。这条路很有想象力,但它处理的是"怎么自然地改写视频"。"应该改成什么结构"这件事,仍然悬在上面。
把这次失败拆开看,现有工具能解决不少局部问题:
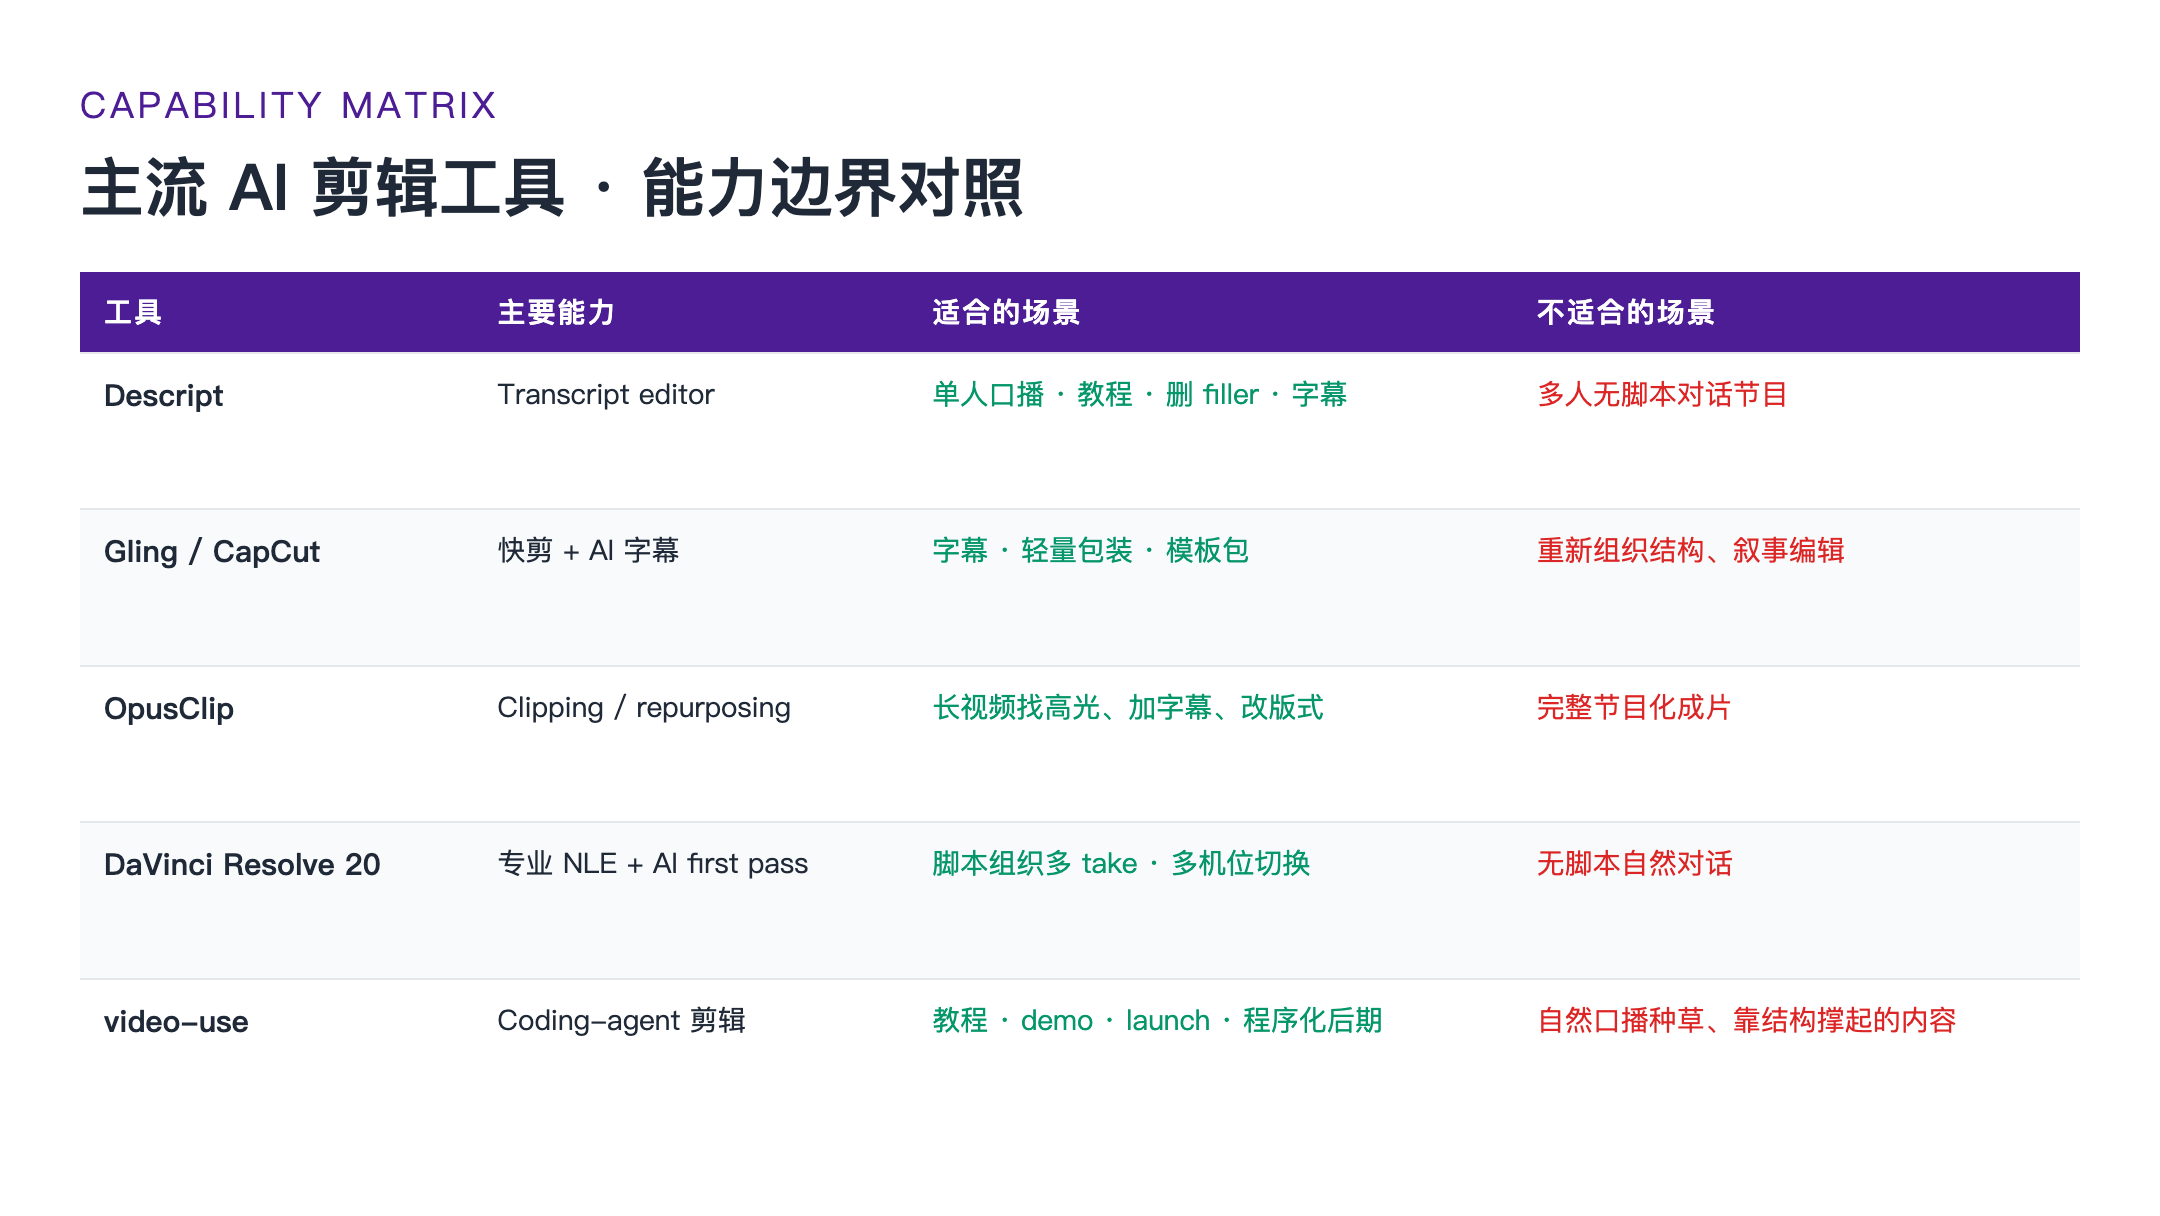
这张表看下来,问题也就变得很朴素了:再找一个更会删 filler 的工具,帮助有限。删之前,要先建立结构判断。
video-use 适合什么,不适合什么
按 video-use 的项目定位,它更像一个"会写代码的助理剪辑师"。全自动主编这个担子,对它来说太重了。
它最适合的任务,是结构已经比较清楚、剪辑目标能写成 EDL 的任务:
- 单人或少数人的 talking head:删停顿、删口误、删 false start,保留清晰表达
- 教程、demo、launch video:内容结构基本写在 transcript 里,比如 HOOK -> PROBLEM -> SOLUTION -> DEMO -> CTA
- 多 take 选段:从多条素材里挑每个 beat 最好的 take
- 程序化后期:字幕、overlay、简单动画、色彩、音频标准化、cut-point 自检
- 粗剪 first pass:快速生成一个可审版本,再进入人工精修
这些任务有一个共同点:剪辑判断大多能从文字和时间戳里推出来。LLM 读 transcript,再按需看局部 timeline_view,就足够做出一版可用 EDL。
但这次的好物分享素材,正好踩在它的弱区:
- 它是无脚本自然对话,但最终成片需要节目结构
- 两个人之间的玩笑、反应、callback、语气本身有内容价值
- "好不好看"取决于类目组织、人物关系、节奏铺垫,信息密度只占一部分
- 中文品牌词、快语速、重叠说话,会让 STT 和卡片锚定不稳定
- 产品分享要安排"为什么看、按什么顺序看、最后记住什么",不能只把产品排成清单
所以这次失败并不抵消 video-use 的价值。我只是把它放得太靠前了。它适合承担执行层;结构判断还没完成时,直接让它坐到主编位,结果就会飘。
可能的解法:不要先剪,先标结构
如果再做一次,我不会从删词开始。
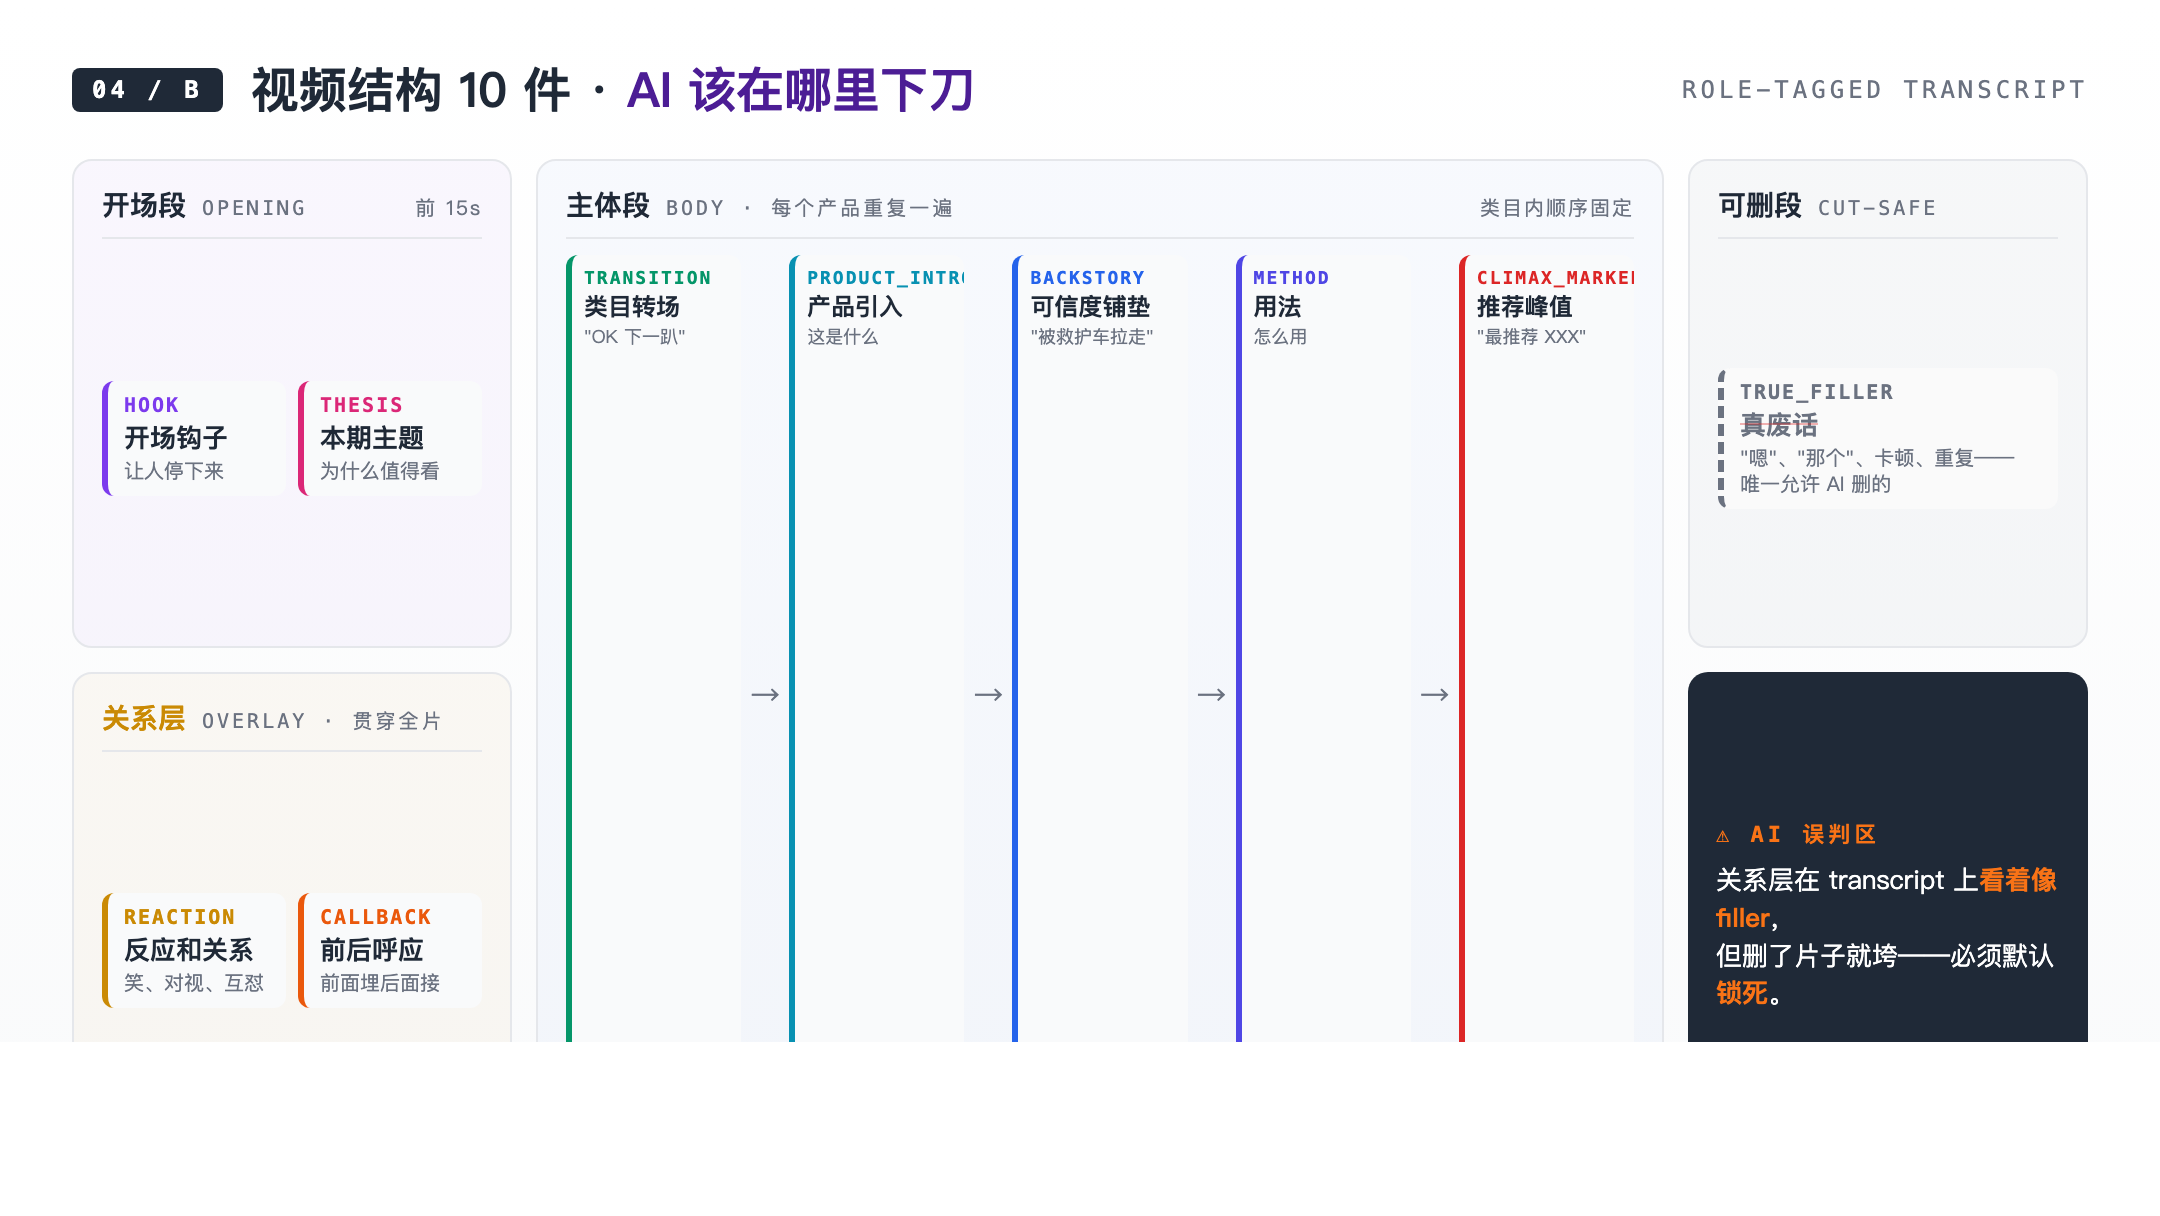
我会先让系统生成一份 role-tagged transcript。时间戳和说话人只是底账,更重要的是给每一段打结构角色:
- HOOK:开场钩子
- THESIS:本期主题
- CATEGORY_TRANSITION:类目转场
- PRODUCT_INTRO:产品引入
- BACKSTORY:可信度铺垫
- METHOD:用法
- REACTION:反应和关系
- CALLBACK:前后呼应
- CLIMAX_MARKER:推荐强度标记
- TRUE_FILLER:真正可删的废话
然后再做一个三层结构表:
1. 顶层:这条视频的开场、主题、几个大类、收尾是什么 2. 中层:每个类目下有哪些产品,顺序为什么这样排 3. 底层:每个产品的痛点、品牌、用法、推荐力度是否完整
这两步过了,再进入 cut list。
而且每一条删除都要带 role 理由。只写"这句没信息,所以删",不够。要写清楚:这是 TRUE_FILLER,可以删;这是 BACKSTORY,可以压缩但不能消失;这是 CATEGORY_TRANSITION,不允许删。
看起来只是多了一张表,其实是换了目标:从"压缩文字",变成"保留结构,压缩冗余"。
现阶段最可行的工作流
我现在不太相信"一键自动成片"。至少这种自然口播好物分享,最好别从这里开始。
更现实的方案是人机分工:
第一步,AI 做素材理解:转写、说话人分离、词级时间戳、初步分段。
第二步,AI 做结构草图:标出 hook、类目、产品微弧、回调、推荐峰值、可疑 filler。
第三步,人审结构,先别急着逐词审剪辑。人只需要判断:这个结构对不对?哪些产品要更重?哪些桥段必须保留?哪些玩笑不能删?
第四步,AI 根据通过的结构做 EDL:只在允许裁切的区域里删词、缩短停顿、压缩重复。
第五步,再交给成熟工具做执行层。内部 preview 可以继续用本地 ffmpeg 管线;发布级内容,最好导出 XML 到 Premiere、Final Cut 或 Resolve 里精修。
第六步,交付前做 reference alignment。时长和字幕当然要看,但还不够。结构件还在不在,每个类目的时长是否合理,推荐峰值有没有保住,产品卡片是否跟第一次口播品牌对齐,这些都要过一遍。
最要紧的是把"结构审片"前置。模型当然可以更强,但顺序错了,强也强不到点上。
针对这类自然口播好物分享,我会把流程压成这样:
1. 人工定结构 先把 STT transcript 做成 paper edit,不急着剪。每段先标 role:hook、类目转场、产品引入、backstory、用法、reaction、callback、推荐峰值、true filler。
2. 人审结构表 每个产品一行:类目、产品、推荐理由、用法、必须保留的反应/玩笑、目标时长、卡片出现点。人只审这张表,不逐字审 100 条删词。
3. AI 生成 EDL 让 video-use 在结构约束下执行:只能删 TRUE_FILLER;BACKSTORY/METHOD 只能压缩;HOOK/TRANSITION/CALLBACK/REACTION/CLIMAX 默认不可删。每条 cut 必须带 role 理由。
4. 专业工具精修 如果只是内部 preview,可以继续用 video-use 的 ffmpeg 管线;如果要发布级,最好导出 XML/EDL 到 Premiere、Final Cut 或 Resolve,人工修节奏、画面和切口。
5. 字幕和卡片单独终审 中文品牌词不能完全信 STT。要用人工品牌词表 + 词级时间戳校准。字幕可以继续走 AI/ASS/剪映,但发布前必须完整过一遍。
6. 交付前做 reference alignment 错字只是最表层。还要检查结构:hook 是否还在、类目转场是否还在、每类产品时长是否合理、推荐峰值产品是否保住、callback 是否被误删。
这套流程的分工很朴素:人做主编判断,AI 做机械剪辑和版本生成。video-use 的优势也在这里,放在执行层会很顺;一旦让它按信息密度去主导全片,就容易把节目骨架剪掉。
对 PMM 来说,现实账并不划算
这次还有一个更现实的体感:对于这种简单一点的视频,自己剪辑,再配合剪映、CapCut 这类成熟工具里的 AI 字幕、自动识别、模板和包装功能,反而更快。
这听起来有点反直觉。video-use 这样的项目更"AI native",也更开放、可控、自动化程度更高。但真实工作里的效率,要把准备成本、调试成本、返工成本、审片成本一起算进去。
对一个 PMM 来说,视频制作很多时候并不是每天稳定批量发生的工业流程。更多时候,是为了发布、活动、产品更新、社媒内容临时做一条。素材不一定标准,脚本不一定完整,成片判断还很主观。真正耗时间的地方,往往卡在"这条内容到底怎么讲才顺",第 38 秒到第 42 秒该怎么剪,反倒是后面的事。
这种情况下,AI skill 能省下来的剪辑时间其实有限。甚至因为要转写、写规则、审 EDL、排查字幕、修卡片、重新渲染,整体时间可能比直接手剪更长。
更准确地说,这类 AI 剪辑项目现在更适合高度结构化、可规模化、可复用的工业场景:
- 高频产出同类视频
- 有明确脚本或模板
- 结构稳定,判断标准可规则化
- 粗剪量大,人工只做抽检
- 团队愿意先投入流程建设,再摊薄到后续产能里
但对公司里的 PMM 相关岗位,尤其是"偶尔需要自己做一条视频"的场景,它们现在的提升并不稳定。很多时候,成熟剪辑软件 + 内置 AI 字幕/包装功能 + 人工判断,仍然是投入产出比最高的方案。
这并不说明 video-use 这类工具没有价值。它的价值只是没落在"让一个 PMM 偶尔做视频时立刻省时间"这件事上。它更像是给未来的结构化视频生产线打底:当视频类型固定、产量足够高、流程可以沉淀时,它的透明 EDL、可复现管线和自动化后期,才开始有经济意义。
更远一点的可能性
从研究方向看,生成式视频编辑正在往"重写视频"走。比如 2026 年一篇 talking-head 研究已经开始探索通过音频和文本来添加、删除、重定时口播内容,并用视频补全保持口型和动作一致。
这类技术以后可能会解决另一个问题:现在的剪辑只能删除和拼接已有片段,没法自然地重写表达。一旦 talking-head video reauthoring 成熟,系统就不必停在删"就是"这一步了,它可以把一段松散口播改写得更顺,再生成匹配的嘴型和动作。
但它救不了这次失败。即使未来能重写视频,系统也得先知道哪些结构该保留、哪些表达值得重写。
生成能力会提高执行上限,但不会自动解决剪辑判断。
最后
这次实验之后,我对 AI 剪辑的期待变得具体了很多。
我已经不再把它想成"把素材丢进去,自动出片"。更合理的理解是:AI 可以压缩很多机械劳动,但它需要明确的结构目标。
video-use 这类 transcript-first 的方案方向是对的:可控、透明、能落地,也比黑箱一键剪辑更适合迭代。只是要处理好自然口播内容,继续堆 filler word 规则没什么用,下一步该补结构层。
这次失败,问题不在 AI 不会剪废话。
问题在于,我让它先剪废话,却还没教它分辨什么根本不是废话。
---
延伸参考:
- browser-use/video-use 开源项目:https://github.com/browser-use/video-use
- Descript filler word removal:https://help.descript.com/hc/en-us/articles/10164806394509-Filler-words
- Adobe Premiere Pro text-based editing:https://helpx.adobe.com/premiere-pro/using/video/text-based-editing-video.html
- Gling AI text-based video editor:https://www.gling.ai/save-time
- OpusClip ClipAnything / text-based editor:https://help.opus.pro/docs/article/introduction-to-opusclip
- CapCut filler word remover:https://www.capcut.com/tools/filler-words
- DaVinci Resolve 20 New Features Guide:https://documents.blackmagicdesign.com/SupportNotes/DaVinci_Resolve_20_New_Features_Guide.pdf
- EditYourself: Audio-Driven Generation and Manipulation of Talking Head Videos:https://arxiv.org/abs/2601.22127
- Filler Word Detection and Classification:https://arxiv.org/abs/2203.15135